Ne manquez plus aucune de nos publications :

Des chercheurs sud-coréens ont présenté SceneQueryPlanner, une méthode qui permet à un agent robotique de consulter sélectivement une mémoire spatiale avant d’agir. Leur idée est simple : au lieu de demander à un grand modèle de langage de retenir tout ce qu’il a observé, le système lui apprend quand vérifier une information précise sur les objets et les pièces qui l’entourent.
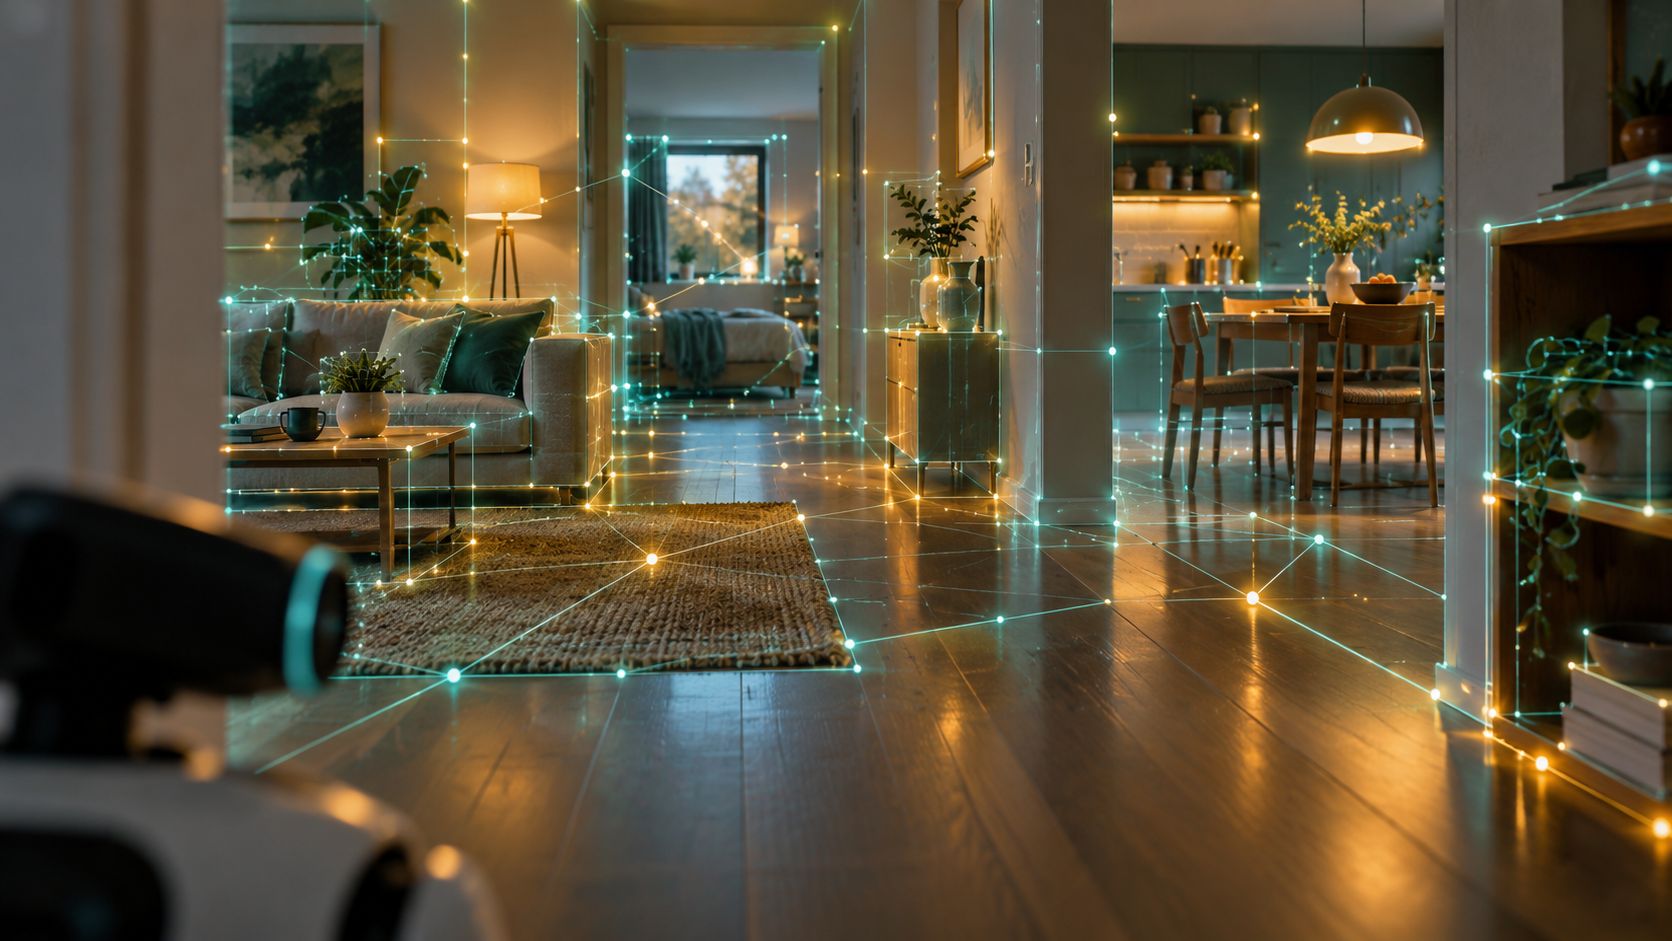
SceneQueryPlanner maintient un graphe dynamique de la scène en 3D. Les objets, les pièces, leurs propriétés et leurs relations y sont représentés sous forme de nœuds et de liens. L’agent peut par exemple rechercher tous les objets portant une certaine étiquette, demander où se trouve un élément ou vérifier ses relations spatiales. Cette mémoire évolue au fil des observations plutôt que d’être construite une fois pour toutes.
Le planificateur ne reçoit pas automatiquement l’intégralité du graphe à chaque étape. Il décompose une instruction, choisit entre une action physique et une requête structurée, puis récupère uniquement l’information utile à la décision immédiate. Pour une consigne telle que placer dans une boîte l’objet en bois posé sur un bureau, il peut d’abord vérifier le matériau et l’emplacement au lieu de se fier à une hypothèse produite par le modèle de langage.
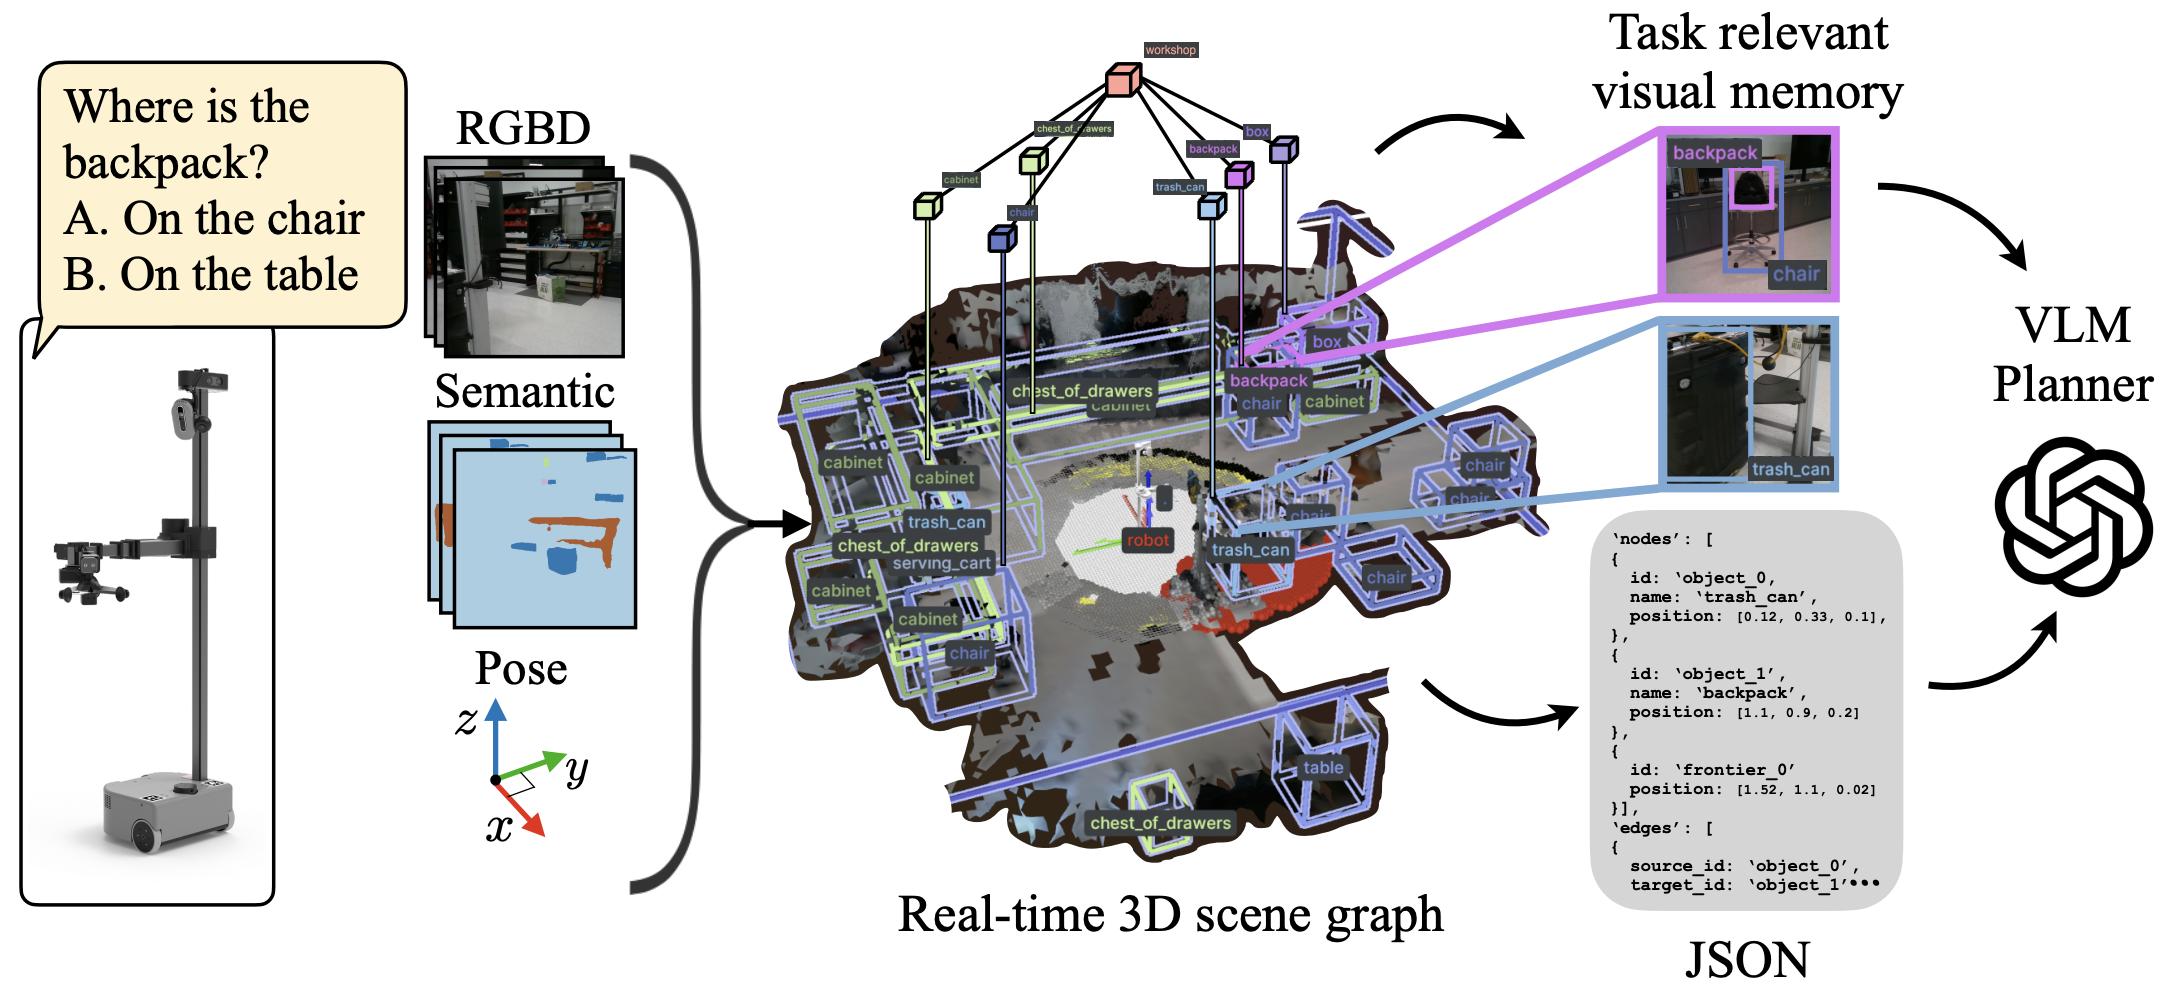
SceneQueryPlanner alterne observation de l’environnement, consultation d’une mémoire spatiale et planification des actions. Crédit : ETRI.
Cette approche cherche à résoudre deux défauts opposés. Une observation trop pauvre omet parfois une propriété décisive, comme la matière ou l’état d’un objet. À l’inverse, injecter toute l’histoire de la scène dans le contexte du modèle ajoute du bruit et augmente le coût de calcul. Les auteurs traitent donc la recherche d’information comme une action de planification à part entière, au même niveau que se déplacer, saisir ou déposer un objet.
L’équipe d’ETRI, de l’Université des sciences et technologies et du Gwangju Institute of Science and Technology a créé AttPlan-Bench pour évaluer ce mécanisme. Le banc d’essai comprend des tâches domestiques longues réparties dans plusieurs pièces, ainsi que des instructions où la bonne décision dépend d’attributs ou de relations. Les chercheurs ont séparé 500 exemples d’entraînement et 500 exemples de test.
Avec Llama 3.1 70B, SceneQueryPlanner atteint un taux de réussite de 69,6 % sur la partie AttPlan-Attr, contre 46,8 % pour ReAct, qui ne dispose pas de mémoire externe structurée. SayPlan obtient 18 % et MoMa-LLM 37,2 % dans la même configuration. Avec Qwen 2.5 72B, le nouveau système atteint 68 %, contre 44 % pour ReAct. Ces chiffres montrent que la présence d’une mémoire ne suffit pas : les deux autres méthodes qui accèdent aussi à un graphe restent nettement derrière lorsque les informations sont consommées de façon moins ciblée.
Les résultats sont plus modestes sur WAH-NL, un autre ensemble de tâches domestiques. SceneQueryPlanner y obtient 26 % avec Llama 3.1 70B et 29 % avec Qwen 2.5 72B. Il reste devant les méthodes comparées, mais la faible réussite absolue rappelle que la planification sur une longue séquence demeure difficile, même avec une meilleure mémoire.
L’étude a été conduite dans des environnements simulés fondés sur la physique. Ce choix rend les comparaisons reproductibles et permet de multiplier les scénarios, mais il ne reproduit pas toute la variabilité d’un logement réel. Un robot dépendrait de caméras, de capteurs de profondeur, d’un module de perception et d’actionneurs susceptibles de commettre leurs propres erreurs.
Les auteurs reconnaissent que des détections incorrectes ou une mauvaise estimation d’attribut peuvent contaminer le graphe et conduire le planificateur à agir sur de fausses prémisses. Leur interface emploie aussi un ensemble prédéfini de requêtes. Une maison réelle contient des objets inattendus, des personnes qui déplacent des éléments et des propriétés difficiles à mesurer ; il faudra donc rendre les questions plus flexibles et améliorer la capacité de récupération après un échec.
L’analyse de 80 trajectoires ratées avec Qwen 2.5 72B attribue 29 % des échecs à la planification de long terme, 19 % à la compréhension de l’objectif et 15 % au raisonnement. Les hallucinations représentent également 15 %, tandis que les erreurs de syntaxe des requêtes ne comptent que pour 4 %. Autrement dit, la mémoire ciblée réduit une partie du problème sans remplacer un meilleur raisonnement général.
Le projet complète d’autres recherches visant à rapprocher le calcul de l’action, comme PixelTac pour le toucher robotique. SceneQueryPlanner agit davantage au niveau de la décision : il ne fournit ni nouveau capteur ni nouvelle mécanique, mais une façon de vérifier les faits avant d’engager une action potentiellement irréversible. L’article scientifique, publié dans les Findings d’EMNLP 2026, compte 22 pages et le code ainsi qu’AttPlan-Bench sont accessibles publiquement sur GitHub.
Netflix a renouvelé Haunted Hotel pour une troisième saison, attendue en 2027. L’annonce arrive trois semaines après la mise en...
OVHcloud chiffre les conséquences de la taxe au gigaoctet votée à l’Assemblée nationale : entre 23 et 70 millions...
La série Harry Potter de HBO complète la population surnaturelle de Poudlard : cinq acteurs ont été choisis pour incarner le...
Des chercheurs ont conçu un phototransistor capable de détecter une lumière infrarouge extrêmement faible et d’alimenter...
Google a reçu une première réponse produite par son matériel d’intelligence artificielle en orbite. Le prototype de...







Utilitaires

Photo et vidéo

Jeux

Météo

Photo et vidéo

Utilitaires

Jeux

Références

Jeux

Références

Horreur

Comédie

Horreur

Horreur

Comédie

Drame
Science-fi et fantasy
Drame