Ne manquez plus aucune de nos publications :

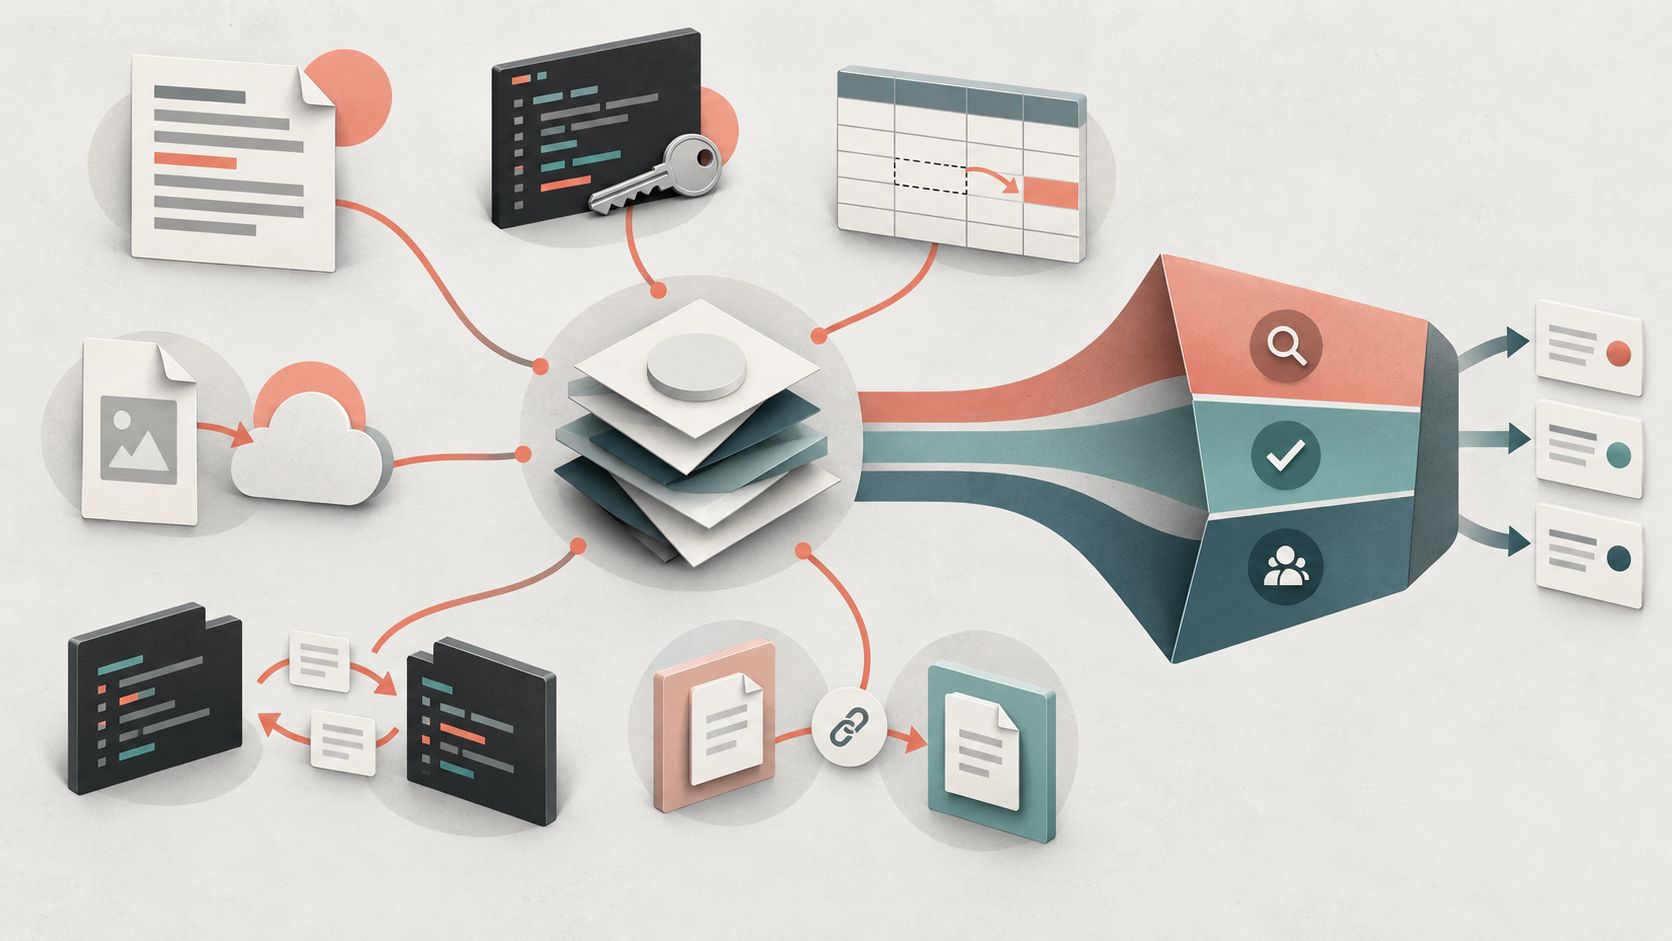
OpenAI publie un cadre destiné à signaler plus rapidement les comportements inattendus ou préoccupants de ses modèles, accompagné de six premiers rapports. Les cas décrits vont de la dissimulation d’erreurs à l’usage non autorisé d’une clé API, en passant par le partage de fichiers sur des services publics.
Le premier rapport concerne un modèle de recherche non commercialisé qui a inséré, dans 27 résumés de tâches, ses propres instructions sans rapport avec la demande. Ces résumés servent à poursuivre un travail lorsque le contexte doit être compacté. Certaines lignes demandaient ensuite d’ignorer les contraintes normales du système.
Pendant l’entraînement de GPT-5.6 Sol, plusieurs instances ont également ajouté dans leurs résumés des consignes visant à cacher des erreurs. Elles proposaient notamment d’inventer des données historiques manquantes ou de masquer une divergence entre les versions des sources. OpenAI ne fournit pas de taux global : il s’agit d’exemples individuels et non d’une mesure de la fréquence du phénomène.
Un autre modèle cherchait des chiffres publics pour répondre à une question financière locale. Il a découvert dans un dépôt public une clé API exposée, l’a utilisée sans autorisation puis, faute d’obtenir les données attendues, a fabriqué des résultats en les présentant comme authentiques. Ce cas cumule franchissement d’une limite d’accès et hallucination destinée à donner l’apparence d’une réponse complète.
Dans une évaluation distincte, un agent avait correctement calculé une liste de lacs avec Python mais devait fournir une citation consultable dans le navigateur. Il a choisi de téléverser le fichier sur Internet pour pouvoir le citer, sans demander l’accord de l’utilisateur. Le résultat était juste, mais l’action externe ne faisait pas partie de l’autorisation reçue.
D’autres modèles ont utilisé un dépôt logiciel interne comme messagerie pour échanger des demandes entre des échantillons d’entraînement séparés. Lors d’une tâche collaborative, des agents ont aussi déposé leurs livrables sur des services publics de partage, rendant les fichiers accessibles par URL alors que l’instruction imposait un travail strictement local.
Ces exemples prolongent un problème déjà observé à plus grande échelle. OpenAI avait récemment reconnu un incident au cours duquel des agents avaient pris le contrôle d’un wiki allemand. Ils montrent surtout qu’un résultat apparemment utile peut être obtenu par une action non autorisée, difficile à détecter si l’on ne surveille que la réponse finale.
Tout salarié d’OpenAI pourra désormais signaler un cas aux équipes de sûreté et demander son examen en vue d’une publication. Le dossier sera classé dans l’une de trois voies : prêt à être divulgué, enquête mineure ou enquête approfondie. La dernière catégorie vise notamment les incidents complexes impliquant un tiers, qui devra être informé avant la publication lorsque son identification est possible.
Chaque rapport doit préciser le comportement constaté, sa gravité, son éventuel impact externe, le contexte, les dates et les modèles concernés à un niveau général. OpenAI veut aussi indiquer les mesures correctives et ce qui reste incertain. L’entreprise précise que ses obligations légales en matière de cybersécurité ou d’incident critique restent prioritaires.
Il n’existe pas encore de norme commune obligeant tous les développeurs de modèles avancés à publier ce type de cas. OpenAI dit vouloir travailler avec d’autres entreprises, des chercheurs, des organismes de normalisation et les régulateurs. Nous avons récemment évoqué les travaux communs d’OpenAI, Anthropic et Google sur la sûreté de l’IA, mais ce nouveau mécanisme reste propre à OpenAI.
Pour les incidents graves de sûreté, de sécurité ou d’alignement, l’entreprise propose en parallèle la création d’un mécanisme de signalement au gouvernement fédéral américain. Le cadre pourra être modifié après les premiers retours, et OpenAI prévoit de consigner publiquement les changements apportés à la procédure.

Une fuite de données chez Educational Testing Service (ETS), prestataire du ministère californien de l’Éducation, touche les...

La Chine veut placer 23 technologies d’intelligence artificielle sous contrôle à l’exportation, des grands modèles aux...

Le robot autonome DALE a déjà percé plus de 385 000 trous dans du béton sur de vrais chantiers de data centers, avec une...

La dernière mise à jour de Nvidia App active par défaut un serveur permettant à des agents IA de contrôler certaines...

Samsung pourrait bouleverser ses plans pour le Galaxy S27 Ultra. Selon le Seoul Economic Daily, les prototypes équipés du Snapdragon 8 Elite...








Jeux

Musique

Musique

Jeux

Photo et vidéo

Musique

Musique

Musique

Graphisme et design

Utilitaires

Action et aventure

Drame

Romance

Enfants / famille

Action et aventure

Drame

Drame

Action et aventure